Scanne Deinen Kubernetes Cluster
Einführung
Kubernetes vereinfacht den Betrieb und die Skalierung containerisierter Workloads, kann die IT-Dokumentation aber anspruchsvoller machen. Ein Cluster kann viele Namespaces, Services, Nodes, Pods, Container und Images enthalten, während sich der Endpunkt für die API nicht wie ein gewöhnlicher Host im Netzwerk verhält.
JDisc Discovery kann konfigurierte Kubernetes-Cluster als Teil der PaaS-Discovery inventarisieren. Dieser Artikel erklärt, wie Sie den Zugriff bereitstellen, welche Informationen JDisc Discovery ausliest und welche Berechtigungen Sie benötigen, wenn zusätzlich Anwendungsinformationen aus Containern erfasst werden sollen. Einen Überblick über die Inventarisierung heterogener IT-Umgebungen finden Sie auf der Seite zu JDisc Discovery.
Warum Kubernetes-Inventarisierung einen eigenen Zugriffsweg benötigt
Frühere Versionen von JDisc Discovery ermöglichten die Definition von Standard-Zugriffstokens für Kubernetes, die bei einem gefundenen Cluster ausprobiert wurden. In der Praxis ist dieses Modell wenig sinnvoll, da Cluster in der Regel kein gemeinsames Token verwenden. Hinzu kommt ein wichtiger Unterschied zur klassischen Network Discovery: Der Cluster-Node, der die Kubernetes-API bereitstellt, muss für einen direkten Scan erreichbar sein. Cloud-Installationen antworten jedoch häufig nicht auf Ping, obwohl der API-Port für Anfragen offen ist.
Kubernetes-Cluster werden deshalb im Bereich PaaS der Discovery-Konfiguration explizit eingerichtet. Ein PaaS-Discovery-Job verbindet sich anschließend mit diesen konfigurierten Umgebungen, statt auf eine Ping-Antwort oder ein generisches Token angewiesen zu sein.
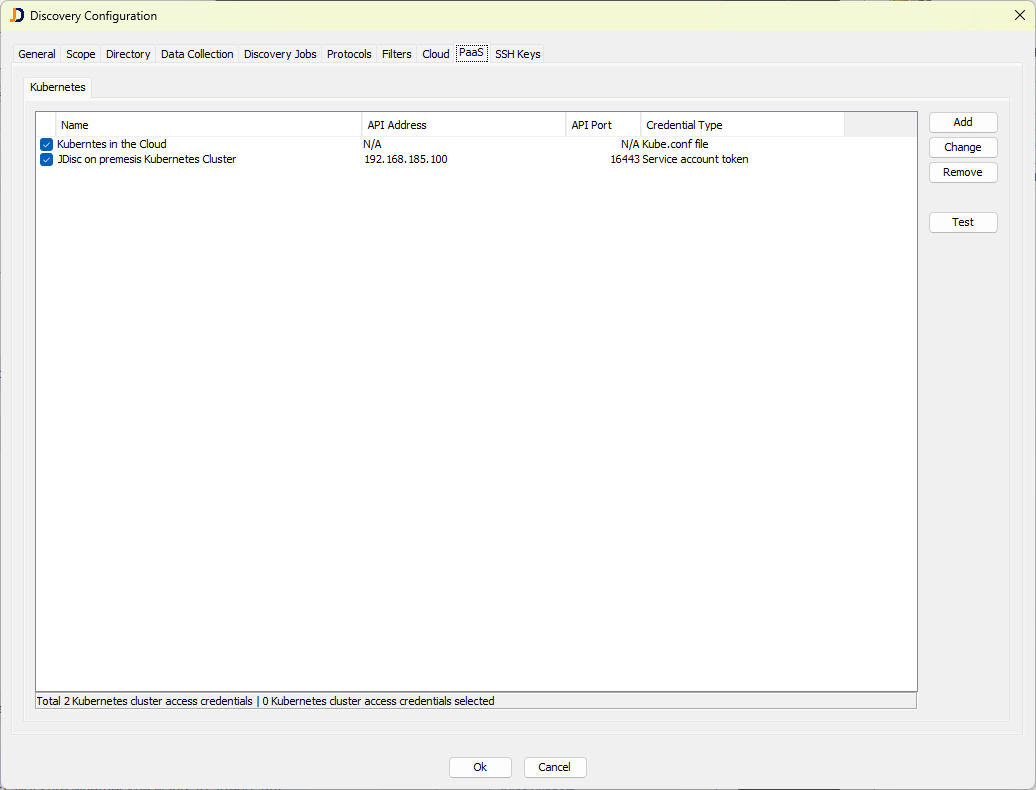
Bildunterschrift: Kubernetes wird in der Discovery-Konfiguration von JDisc Discovery als PaaS-Eintrag eingerichtet.
Zugriff auf einen Kubernetes-Cluster konfigurieren
Es gibt zwei Möglichkeiten, JDisc Discovery Zugriff auf einen Kubernetes-Cluster zu geben:
- Ein Service-Account-Token
- Eine kube.conf-Datei
Wählen Sie die Variante, die zu der Identität und den Berechtigungen passt, die für die gewünschten Informationen erforderlich sind. Vergeben Sie für den Zugriffseintrag einen aussagekräftigen Namen und Kommentar, damit Administratoren seinen Zweck später erkennen können.
Service-Account-Token verwenden
Kubernetes-Administratoren können Service Accounts und langlebige Zugriffstokens erstellen. Wählen Sie in JDisc Discovery Add, um Zugriff auf einen Kubernetes-Cluster einzurichten, anschließend Service account token als Credential-Typ und tragen Sie die IP-Adresse oder den Hostnamen des Clusters, den Port sowie das Service-Account-Token ein.
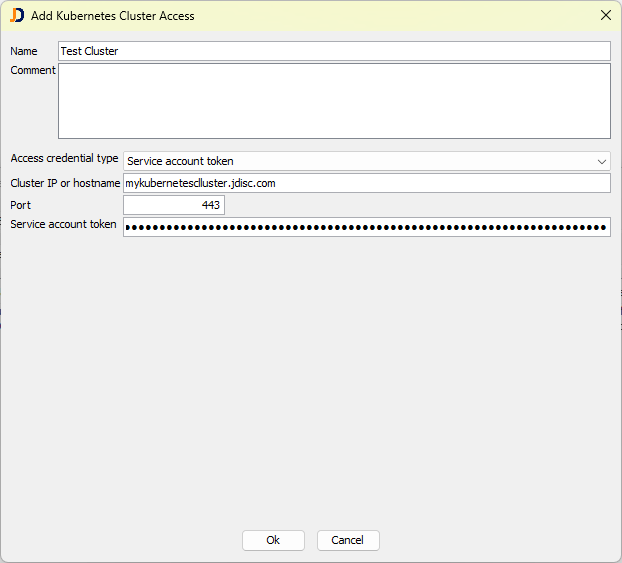
Bildunterschrift: Der Dialog für token-basierten Zugriff enthält den Cluster-Endpunkt und das Service-Account-Token.
Ein Service Account kann eine praktische Wahl sein, wenn der benötigte Discovery-Umfang begrenzt ist. Beachten Sie jedoch, dass Service Accounts pro Namespace gelten und ihr Zugriff nicht automatisch auf Pods in anderen Namespaces ausgeweitet wird.
kube.conf-Datei verwenden
Eine kube.conf-Datei ist die zweite Möglichkeit, Zugriff zu gewähren. Sie enthält Adresse, Credentials und Zertifikate, die für den Zugriff auf den Kubernetes-Cluster benötigt werden. Sie kann geeignet sein, wenn die Discovery einen normalen Benutzer und eine Cluster-Role-Zuweisung mit den erforderlichen Berechtigungen über Namespaces hinweg benötigt.
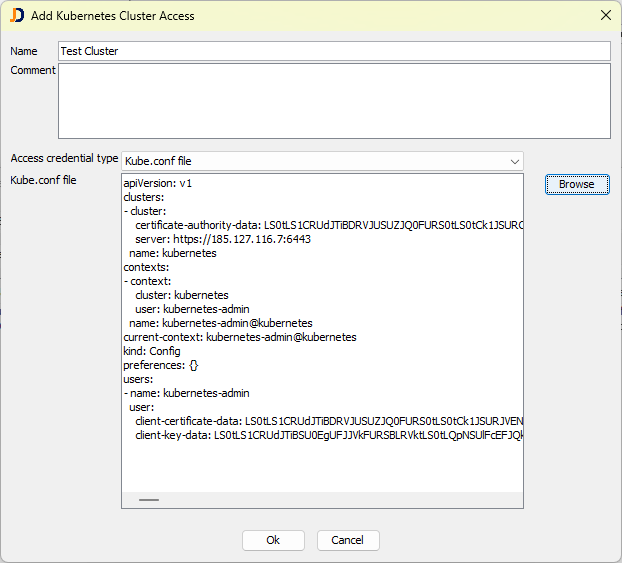
Bildunterschrift: Die kube.conf-Option stellt Cluster-Verbindungsinformationen und Credentials bereit.
Unabhängig von der gewählten Methode prüfen Sie die Credentials mit der Schaltfläche Test, bevor Sie sie in einem geplanten Job verwenden.
Aus dem Cluster erfasste Informationen
Mit den notwendigen Berechtigungen liest JDisc Discovery die folgenden Kubernetes-Artefakte aus:
- Namespaces
- Services
- Nodes
- Pods
- Container
- ReplicaSets
- DaemonSets
- Container-Images
Diese Daten helfen dabei, die Struktur eines konfigurierten Clusters neben der übrigen IT-Umgebung sichtbar zu machen. Sie sind besonders nützlich, wenn ein Team die Kubernetes-Inventarisierung mit seinen umfassenderen Geräte- und Softwaredaten verbinden möchte. JDisc Discovery bietet außerdem optionale Add-ons für Organisationen, die ihre Discovery-Daten um weitere Netzwerk-, Security-, Historien- oder Abhängigkeitsinformationen erweitern möchten.
Erforderliche Kubernetes-Berechtigungen
Um die oben genannten Kubernetes-Artefakte auszulesen, benötigt die konfigurierte Identität mindestens die folgenden Verben:
getlist
Die Berechtigungen sollten bewusst vergeben und entsprechend dem Kubernetes-Zugriffsmodell Ihrer Organisation überprüft werden. Der benötigte Umfang hängt davon ab, ob die Discovery einen Namespace oder Informationen im gesamten Cluster sehen soll.
Anwendungen in Containern erfassen
JDisc Discovery kann außerdem die Liste der Anwendungen abrufen, die in einem Container innerhalb eines Pods laufen. Dafür ist die Berechtigung pod/exec erforderlich, weil JDisc Discovery Befehle innerhalb des Containers ausführt.
Hier wird das Zugriffsmodell entscheidend. Ein Service Account gilt pro Namespace und verfügt nicht über Berechtigungen für andere Namespaces und deren Pods. Für pod/exec-Zugriff auf Pods über alle Namespaces hinweg verwenden Sie eine kube.conf-Datei mit einem normalen Benutzer und einer passenden Cluster-Role-Zuweisung, die die erforderlichen Berechtigungen enthält.
Diese Unterscheidung ist bei der Planung des Discovery-Umfangs wichtig: Die grundlegende Kubernetes-Inventarisierung und die Erfassung von Anwendungen innerhalb von Containern können unterschiedliche Credentials und Berechtigungen erfordern. Behandeln Sie Credentials als verwalteten Bestandteil Ihrer Discovery-Konfiguration und nicht als Standard-Token, das gegen jeden Cluster ausprobiert wird.
PaaS-Discovery-Job erstellen
Nachdem Sie den Clusterzugriff konfiguriert haben, erstellen Sie einen Discovery-Job für die PaaS-Discovery der eingerichteten Kubernetes-Cluster. Erstellen Sie den Job über das Kontextmenü in der linken Discovery-Job-Liste, vergeben Sie Namen und Beschreibung und wählen Sie den Job anschließend aus. Weisen Sie dem Job keine Gruppe zu. Wählen Sie auf dem Tab Settings ausschließlich Synchronize PaaS.
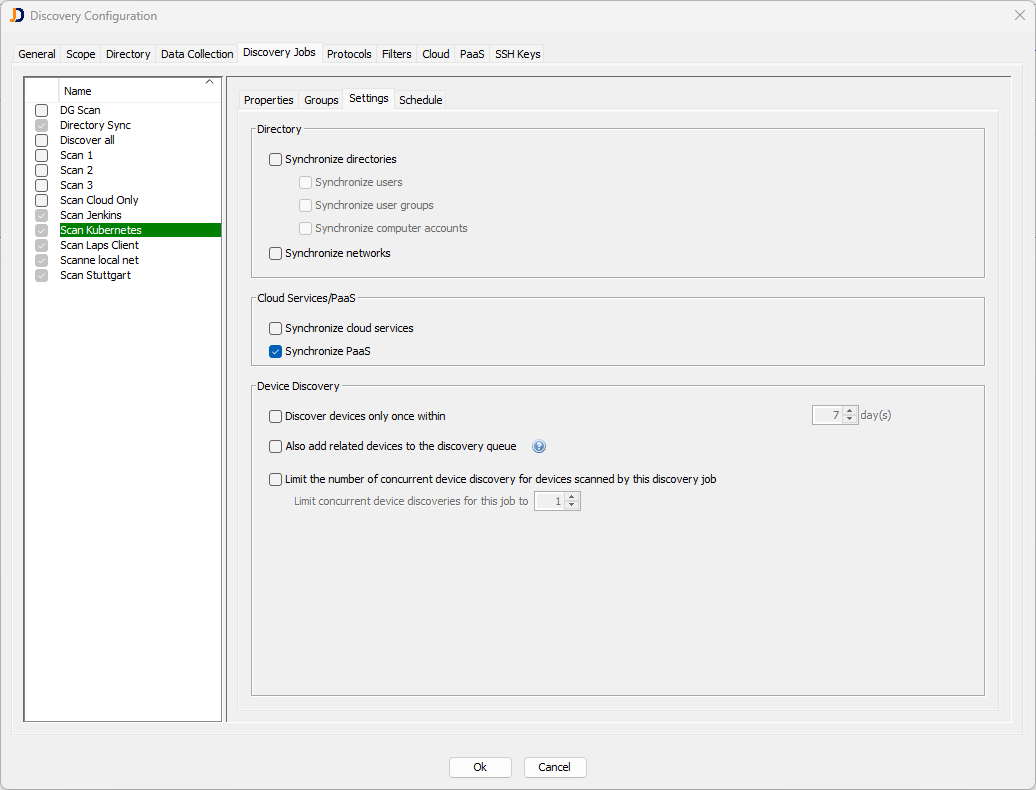
Bildunterschrift: Ein PaaS-Job synchronisiert die in JDisc Discovery konfigurierten Kubernetes-Umgebungen.
Beim Start verbindet sich der Job nur mit den konfigurierten PaaS-Einträgen und scannt diese Umgebungen. Dadurch bleibt die Zugriffsgrenze klar und Kubernetes wird nicht einfach wie ein pingbarer Netzwerkendpunkt behandelt.
Ein praxisnaher Einstieg
Beginnen Sie mit einem Cluster und einer Zugriffsidentität, die auf die benötigten Informationen beschränkt ist. Testen Sie die Verbindung, führen Sie den PaaS-Job aus und prüfen Sie das Inventarergebnis, bevor Sie den Umfang erweitern. Wenn Anwendungsinformationen aus Containern benötigt werden, planen Sie die Berechtigung pod/exec und den erforderlichen Zugriff über Namespaces hinweg separat.
Wenn Sie diesen Ablauf in Ihrer eigenen Umgebung testen möchten, können Sie eine JDisc Discovery Testversion herunterladen oder eine Demo buchen, um den Discovery-Umfang mit uns zu besprechen.
Häufig gestellte Fragen
Diese Antworten behandeln typische Fragen zur Inventarisierung von Kubernetes-Clustern mit JDisc Discovery. Sie erläutern, wie der Clusterzugriff eingerichtet wird, welche Berechtigungen erforderlich sind und wann eine kube.conf-Datei die bessere Wahl ist.
Nein. Cloud-Installationen antworten möglicherweise nicht auf Ping, obwohl der Kubernetes-API-Port für Anfragen offen ist. Kubernetes-Cluster werden explizit als PaaS-Einträge eingerichtet.
Sie können entweder ein Service-Account-Token oder eine kube.conf-Datei verwenden, die Adresse, Credentials und Zertifikate für den Zugriff auf den Cluster enthält.
Bei den erforderlichen Berechtigungen liest es Namespaces, Services, Nodes, Pods, Container, ReplicaSets, DaemonSets und Container-Images aus.
Mindestens die Verben get und list sind erforderlich, um die aufgeführten Kubernetes-Artefakte auszulesen.
Die Berechtigung pod/exec wird benötigt, wenn JDisc Discovery die Liste der Anwendungen abrufen soll, die in einem Container innerhalb eines Pods laufen.
Nein. Service Accounts gelten pro Namespace und verfügen daher nicht automatisch über Berechtigungen für andere Namespaces und deren Pods.
Verwenden Sie eine kube.conf-Datei, wenn die Discovery einen normalen Benutzer und eine passende Cluster-Role-Zuweisung benötigt, etwa für pod/exec-Zugriff auf Pods in allen Namespaces.
Erstellen Sie einen Discovery-Job mit Synchronize PaaS als einziger Einstellung. Der Job verbindet sich dann mit den konfigurierten PaaS-Einträgen und scannt diese Umgebungen.
Über den Autor